Allocation de ressources anti-brouillage par la théorie des jeux : modèles, méthodes et cas d'usage
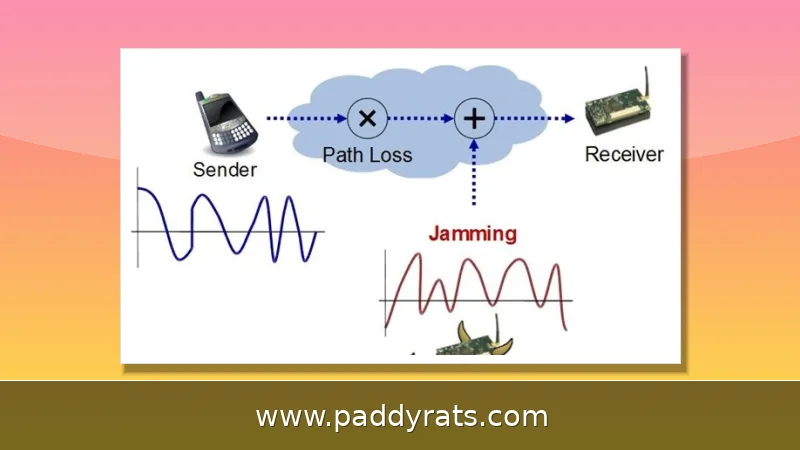
La théorie des jeux et l'apprentissage par renforcement transforment l'allocation de ressources anti-brouillage en modélisant le brouilleur et l'utilisateur légitime comme des joueurs adverses. Voici les modèles, méthodes et cas d'usage qui structurent ce domaine, du jeu de Stackelberg aux réseaux ISAC et aux essaims de drones.
Qu'est-ce que l'allocation de ressources anti-brouillage et pourquoi est-ce devenu central ?
Dans les réseaux sans fil d'aujourd'hui, le brouillage hostile ne se limite plus à dégrader un signal : son but est bien souvent d'épuiser le spectre, la puissance et les canaux dont on dispose. L'allocation de ressources anti-brouillage, c'est justement l'art de répartir ces ressources limitées entre les utilisateurs légitimes, en temps réel, pour que la communication tienne malgré l'attaque. Les travaux sur le sujet touchent à peu près à tout : association des utilisateurs, positionnement des drones, accès au spectre, sélection de canaux, contrôle de puissance.
Le souci, c'est que les méthodes classiques comme le FHSS ou le DSSS misent tout sur la fiabilité au détriment de l'efficacité spectrale. Elles reposent sur des motifs fixes, prédéfinis, sans réelle prise de décision intelligente. Résultat : dès que le brouilleur s'adapte, ces schémas perdent vite de leur efficacité. C'est justement là que la théorie des jeux et l'apprentissage par renforcement (RL) entrent en jeu : dans le domaine anti-brouillage, ils sont décrits comme des outils mathématiques puissants, notamment parce qu'ils permettent de raisonner face à un adversaire qui, lui aussi, réagit.
Comment la théorie des jeux modélise-t-elle l'affrontement entre brouilleur et utilisateur légitime ?
La théorie des jeux considère le brouilleur et l’utilisateur légitime comme deux joueurs aux objectifs opposés, ce qui rend bien compte de leur affrontement naturel. L’idée, c’est que l’utilisateur ne se contente pas de subir le brouillage : il anticipe les choix de l’attaquant et ajuste sa propre stratégie en conséquence. Pour modéliser ce bras de fer, plusieurs cadres sont mobilisés, notamment le jeu de Stackelberg, le jeu de Markov, le jeu bimatrix et le jeu hypergraphe.
Chaque modèle offre un éclairage différent sur le problème. Le jeu de Stackelberg, par exemple, permet de saisir les comportements hiérarchiques et d'analyser les interactions compétitives à plusieurs niveaux. Le jeu de Markov, lui, prend en charge l'évolution temporelle de l'état du canal. Quant au jeu bimatrix, il décrit la relation d'affrontement direct entre deux camps. Le jeu hypergraphe se distingue en représentant fidèlement les relations d'interférence multiples, et le jeu à équilibre corrélé va même jusqu'à tirer parti des signaux de brouillage comme signaux de coordination.
Ces modèles permettent de dégager des stratégies pertinentes lorsque l'information est à la fois dynamique et incomplète. C'est ce que montre notamment l'étude de Gao (2018, citée 130 fois) sur les stratégies anti-brouillage fondées sur la théorie des jeux dans les réseaux sans fil : le cadre game-théorique améliore les performances, et les simulations numériques l'ont bien confirmé. L'intérêt est double, me semble-t-il : d'un côté, on donne une forme explicite à l'adversaire ; de l'autre, on dispose d'un critère d'équilibre pour juger si une allocation de ressources tient la route.
Les modèles clés : Stackelberg, Markov, bimatrix et hypergraphe
Le choix du modèle n'a rien d'anodin : il dépend avant tout de la nature du brouillage et de l'information dont on dispose. Le tableau ci-dessous récapitule les quatre familles les plus fréquemment citées dans la littérature anti-brouillage, en précisant à quoi chacune sert concrètement.
| Modèle | Ce qu'il capture | Usage typique |
|---|---|---|
| Jeu de Stackelberg | Comportements hiérarchiques, interactions à plusieurs niveaux | Brouilleur leader, utilisateur suiveur |
| Jeu de Markov | Évolution de l'état et décisions séquentielles | Brouillage dynamique, information incomplète |
| Jeu bimatrix | Relation d'affrontement direct entre deux joueurs | Choix de canal et de puissance |
| Jeu hypergraphe | Relations d'interférence multiples et précises | Réseaux denses, interférences croisées |
Le jeu de Stackelberg anti-brouillage trouve naturellement sa place quand le brouilleur joue le premier coup et que l'utilisateur légitime riposte. À l'inverse, le jeu de Markov anti-brouillage devient incontournable dès que l'environnement évolue à chaque instant. Quant au jeu hypergraphe, il prend le relais là où plusieurs interférences se superposent, un cas de figure qu'un graphe classique peine à retranscrire fidèlement. Reste le jeu à équilibre corrélé, qui détourne les signaux de brouillage pour en faire des signaux de coordination : l'idée peut surprendre, mais elle s'avère redoutablement efficace pour synchroniser les décisions des utilisateurs légitimes.
Le paradigme d'apprentissage anti-brouillage par la théorie des jeux (GTLAJ)
Le paradigme GTLAJ (game-theoretic learning anti-jamming) a justement été formalisé par Jia et al. dans un article arXiv (2207.00159v1, 20 juin 2022), où les auteurs en posent le cadre et en discutent les principaux défis. L'idée de départ est assez simple à saisir : d'un côté, la théorie des jeux sert à modéliser les interactions stratégiques entre les acteurs en présence ; de l'autre, l'apprentissage permet de faire face à une information forcément dynamique et incomplète, en procédant par essais-erreurs au contact direct de l'environnement de brouillage.
Pour qu’un dispositif anti-brouillage soit réellement intelligent, il ne suffit pas qu’il réagisse vite : il doit aussi être capable de s’auto-détecter, de décider seul, de se coordonner avec d’autres nœuds, de s’auto-évaluer et, surtout, d’apprendre de ses erreurs. C’est là que le paradigme GTLAJ entre en jeu. Son objectif est double : d’un côté, comprendre finement le comportement du brouilleur et les contraintes propres à la lutte anti-brouillage ; de l’autre, exploiter cette connaissance pour construire des modèles adaptés. On pense notamment au jeu de Stackberg anti-brouillage, au jeu de Markov anti-brouillage ou encore au jeu anti-brouillage fondé sur l’hypergraphe, qui permettent de représenter des situations de confrontation plus ou moins complexes.
Les stratégies anti-brouillage se rangent en cinq grandes familles : la confrontation, l’évitement, l’élimination, la dissimulation et la tromperie. Le GTLAJ, lui, se situe un peu à cheval entre la confrontation et un évitement intelligent : il apprend en continu quelle politique rapporte le plus face à un adversaire qui, par définition, ne reste jamais figé.
Pourquoi combiner théorie des jeux et apprentissage par renforcement face à un brouillage dynamique ?
La théorie des jeux formule les interactions stratégiques, mais elle suppose souvent une connaissance des gains et des stratégies adverses. L'apprentissage par renforcement, à l'inverse, gère l'information dynamique et incomplète par essais-erreurs, sans modèle préalable. Ensemble, ils permettent d'atteindre les capacités d'auto-détection, d'auto-décision, d'auto-coordination, d'auto-évaluation et d'apprentissage requises pour un anti-brouillage intelligent.
Cette complémentarité se traduit par des architectures concrètes. Un jeu anti-brouillage hiérarchique couplé au MADRL (multi-agent deep reinforcement learning) formule un modèle hiérarchique pour traiter l'allocation multidimensionnelle de ressources fortement couplée (Du, 2026, cité 4 fois). Dans les réseaux air-sol intégrés, les exigences des tâches, la mobilité des UAV, la topologie du réseau et les décisions d'accès au spectre anti-brouillage sont fortement couplées, ce qui justifie une allocation multidimensionnelle plutôt qu'un simple réglage de puissance.
D'autres travaux illustrent la diversité des formulations. Un jeu de poursuite-évasion pour l'anti-brouillage des AAV modélise l'interaction entre un serveur embarqué sur AAV et un brouilleur comme un jeu partiellement observable, l'algorithme optimisant la politique anti-brouillage par RL tout en restant robuste à la non-stationnarité. Une allocation max-min appliquée à l'anti-brouillage étudie le contrôle de puissance dans un réseau de communication par UAV, avec une métrique max-min qui reflète le concept de gain garanti.
Enfin, l'apprentissage en ligne et l'approximation d'équilibre pour l'anti-brouillage en communication satellite reformulent le problème d'allocation de puissance dans deux cas de figure : chaque joueur dispose d'un budget de ressources fixe et alloue simultanément des ressources à n champs de bataille (Zou, 2022, cité 11 fois). Cette formulation montre que la théorie des jeux ne se limite pas à un canal unique.
Allocation de ressources dans les systèmes UAV, air-sol et ISAC
Dans les réseaux air-sol intégrés, l'allocation de ressources anti-brouillage doit gérer simultanément plusieurs dimensions. Les exigences des tâches, la mobilité des UAV, la topologie du réseau et les décisions d'accès au spectre anti-brouillage sont fortement couplées, ce qui rend les approches classiques insuffisantes (Du, 2026, cité 4 fois).
Pour les systèmes ISAC (integrated sensing and communication), l'allocation de ressources anti-brouillage vise à maximiser le débit pondéré et la puissance de détection effective sous contrainte de coût de puissance (Chen, cité 15 fois). Le défi est double : satisfaire la communication tout en préservant la qualité de la perception.
Dans les réseaux EH-CIoT (energy harvesting cognitive IoT), une méthode d'allocation anti-brouillage modélise le problème comme un processus de décision markovien (MDP) sans connaissance préalable, puis propose une méthode Linearly Weighted Deep visant à maximiser le débit à long terme (LTT) (Li, 2024, cité 2 fois). Pour les communications de drones, un apprentissage par renforcement auto-organisé propose de traiter l'allocation de ressources sous brouillage dynamique, où des cartes auto-organisatrices et des tranches pseudo-aléatoires améliorent la convergence (Zhou, 2025, cité 3 fois).
Un cadre proactif de pré-allocation de ressources anti-brouillage aborde l'allocation anticipée dans des réseaux de communication déployés sur le terrain sous brouillage dynamique par UAV. La relation entre consommation de ressources et durée de brouillage est régie par un modèle mathématique influencé par le type de technologie anti-brouillage, l'intensité du brouillage et la stratégie d'allocation (MDPI, 16 février 2026). Une allocation optimale d'énergie de transmission multi-canaux contre le brouillage détermine des stratégies de transmission économes en énergie via un apprentissage par renforcement piloté par les données, avec une méthodologie de conception des paramètres d'entraînement et des preuves de stabilité (1er octobre 2025).
Sécurité, puissance et équilibres : l'apport des approches game-théoriques
L'allocation de ressources ne concerne pas seulement le débit, mais aussi la sécurité. Les approches d'optimisation et de théorie des jeux pour l'allocation défensive de ressources en sécurité des communications et des réseaux (Xu, 2026) modélisent un jeu entre un interférent allié diffusant du bruit artificiel et un eavesdropper stratégique.
Deux cas ressortent. Lorsque tous les canaux sont attaqués, l'allocation optimale de puissance résout un problème d'optimisation convexe par water-filling. Lorsque l'eavesdropper n'attaque qu'un nombre limité de canaux, un jeu à somme non nulle aide à prédire les cibles. Dans tous les cas, l'allocation de puissance game-théorique offre une capacité de secret totale attendue supérieure à un simple partage égal.
La technologie de communication anti-brouillage intelligente combinant réseaux de neurones profonds et théorie des jeux construit un modèle dédié (Zhao, 2025, cité 8 fois). Les outils d'apprentissage — RL, DRL, MADRL, MDP — y jouent un rôle croissant, car ils s'adaptent à un brouilleur qui modifie sa stratégie en temps réel.
Pour un lecteur qui découvre le domaine, la hiérarchie est la suivante : la théorie des jeux fournit le cadre stratégique et les notions d'équilibre ; l'apprentissage fournit la capacité d'adaptation ; l'allocation de ressources fournit le levier concret (puissance, canal, spectre, position). Les trois se combinent dans les cas d'usage évoqués plus haut, des essaims de drones aux satellites en passant par l'ISAC.
Comment lire la littérature et choisir son modèle ?
Face à la diversité des travaux, une méthode simple consiste à partir de trois questions. Premièrement, le brouilleur est-il hiérarchiquement supérieur, auquel cas un jeu de Stackelberg s'impose ? Deuxièmement, l'environnement évolue-t-il dans le temps, ce qui oriente vers un jeu de Markov ou un MDP ? Troisièmement, les interférences sont-elles multiples et croisées, ce qui plaide pour un jeu hypergraphe ?
Une fois le modèle choisi, la méthode d'apprentissage dépend de l'information disponible. Sans connaissance préalable, un MDP couplé à une méthode profonde comme Linearly Weighted Deep est adapté. Avec plusieurs agents, le MADRL hiérarchique permet de gérer le couplage multidimensionnel. Pour un objectif de gain garanti, la métrique max-min reste une référence.
Enfin, la validation compte autant que le modèle. Les études citées s'appuient sur des investigations numériques et des preuves de stabilité pour confirmer les gains. Le lecteur doit donc vérifier que le scénario testé correspond à son propre cas d'usage : mobilité des UAV, contrainte énergétique, ou exigence de sécurité. C'est à ce prix que l'allocation de ressources anti-brouillage par la théorie des jeux passe du cadre théorique à un bénéfice opérationnel.
Questions fréquentes
Comment la théorie des jeux modélise-t-elle l'interaction entre un brouilleur et un utilisateur légitime ?
La théorie des jeux traite le brouilleur et l'utilisateur légitime comme des joueurs aux objectifs opposés, ce qui capture leur confrontation naturelle. Des modèles comme les jeux de Stackelberg, de Markov, bimatrix et hypergraphe formulent leurs interactions mutuelles et aident à dériver des stratégies sous information dynamique et incomplète.
Quels problèmes d'allocation de ressources sont traités dans la recherche anti-brouillage ?
La recherche couvre l'association des utilisateurs, le positionnement des UAV, l'accès au spectre, la sélection de canaux et le contrôle de puissance. Dans les réseaux air-sol intégrés, les exigences des tâches, la mobilité des UAV, la topologie du réseau et les décisions d'accès au spectre anti-brouillage sont fortement couplées et traitées comme une allocation multidimensionnelle.
Pourquoi combiner théorie des jeux et apprentissage par renforcement pour l'anti-brouillage ?
La théorie des jeux formule les interactions stratégiques, tandis que l'apprentissage par renforcement gère l'information dynamique et incomplète par essais-erreurs. Ensemble, ils permettent l'auto-détection, l'auto-décision, l'auto-coordination, l'auto-évaluation et la capacité d'apprentissage requises pour un anti-brouillage intelligent.
Qu'est-ce que le paradigme d'apprentissage anti-brouillage par la théorie des jeux (GTLAJ) ?
Le GTLAJ est un paradigme proposé pour la communication anti-brouillage intelligente. Il explore les caractéristiques du brouilleur et les exigences anti-brouillage, puis discute des modèles comme le jeu de Stackelberg anti-brouillage, le jeu de Markov anti-brouillage et le jeu anti-brouillage fondé sur l'hypergraphe.