Asignación de recursos anti-interferencia con teoría de juegos: modelos, métodos y casos de uso
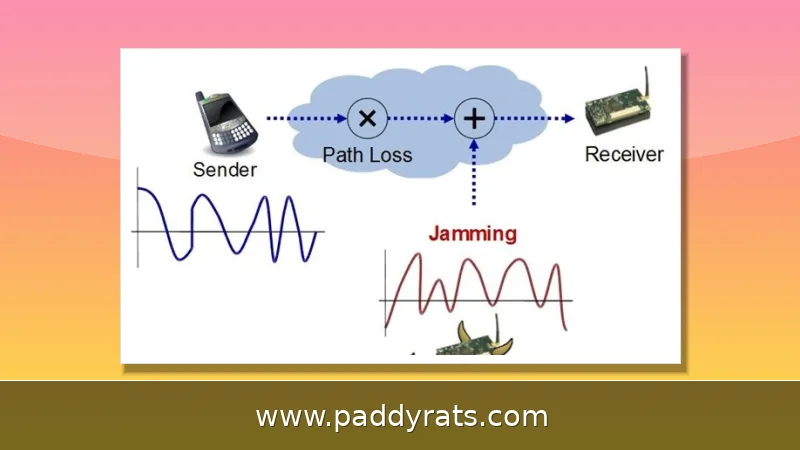
La teoría de juegos y el aprendizaje por refuerzo permiten asignar espectro, potencia y canales para contrarrestar interferencias en redes inalámbricas. Aquí reviso los modelos clave, el paradigma GTLAJ y los casos de uso en UAV, redes aire-tierra e ISAC.
¿Qué es la asignación de recursos anti-interferencia y por qué importa?
La asignación de recursos anti-interferencia (anti-jamming resource allocation) es, en pocas palabras, el conjunto de decisiones con las que se reparten espectro, potencia, canales y posiciones entre usuarios legítimos para mantener la comunicación cuando un interferidor busca degradarla o bloquearla. Al revisar literatura técnica, uno se da cuenta de que el punto medular no es solo “esquivar” la interferencia, sino decidir sobre la marcha qué recurso ceder, cuál proteger y cuánto gastar en ello. Los métodos tradicionales como FHSS y DSSS sacrifican eficiencia espectral a cambio de confiabilidad: usan patrones fijos o preestablecidos y no cuentan con toma de decisiones inteligente, lo que acaba limitando el aprovechamiento de los recursos disponibles.
Hay cinco grandes caminos para enfrentar la interferencia: la confrontación, la evasión, la eliminación, el ocultamiento y el engaño. Y ojo, cada uno te cuesta recursos de forma distinta. Según lo que se ha publicado en el área, un esquema verdaderamente inteligente necesita ser capaz de sensar su entorno, decidir por sí solo, coordinarse con otros, evaluar lo que hizo y, sobre todo, aprender de ello. Por eso hoy la investigación ya no se queda con un solo enfoque: combina modelos estratégicos con aprendizaje, porque el interferidor no se está quieto, el entorno tampoco, y una asignación fija termina quedándose corta. En este artículo vamos a ordenar los modelos, los métodos de aprendizaje y los casos de uso que más se citan.
¿Cómo modela la teoría de juegos la interacción entre interferidor y usuario legítimo?
La teoría de juegos parte de una idea bastante simple pero poderosa: el interferidor y el usuario legítimo son jugadores con metas opuestas, y esa confrontación es natural, no un accidente. En vez de tratar el canal como algo pasivo, el modelo asume que ambos toman decisiones y que cada una afecta lo que gana o pierde el otro. Con ese planteamiento se pueden derivar estrategias bajo información dinámica e incompleta (DI), es decir, cuando ninguno de los dos conoce del todo lo que hará el rival. El aprendizaje entra aquí para lidiar con esas limitaciones a base de prueba y error con el entorno de interferencia. Y cuando juntas las dos cosas —el juego y el aprendizaje—, eso es justamente lo que se conoce como aprendizaje con teoría de juegos.
Entre los modelos concretos están el juego de Stackelberg, que captura comportamientos jerárquicos y analiza interacciones competitivas en distintos niveles; el juego de Markov, que resulta útil cuando el estado va evolucionando; el juego de hipergrafo, que representa con bastante precisión relaciones de interferencia múltiples; el juego bimatrix, que describe la relación de confrontación; y el juego de equilibrio correlacionado, que se aprovecha de las señales de interferencia tomándolas como señales de coordinación. Por su parte, Jia (2024), un trabajo citado 94 veces, plantea la teoría de juegos y el aprendizaje por refuerzo como herramientas matemáticas muy potentes dentro de este campo.
Modelos clave: Stackelberg, Markov, bimatrix e hipergrafo
Cada modelo responde a una estructura de interacción diferente. El juego de Stackelberg anti-interferencia, por ejemplo, captura jerarquías: hay un jugador que va al frente (piensa en el sistema legítimo) y que define su política primero, y luego el seguidor, o sea el interferidor, reacciona a esa decisión. El juego de Markov anti-interferencia, por su parte, modela transiciones entre estados y por eso se vuelve la base natural cuando quieres combinarlo con aprendizaje por refuerzo. También está el juego bimatrix, que describe la confrontación directa entre dos partes con pagos simétricos o asimétricos. Y el juego basado en hipergrafo cubre un caso más complejo: relaciones de interferencia donde hay más de dos nodos metidos en la jugada al mismo tiempo.
Abajo va una tabla que resume qué función cumple cada modelo y qué tipo de información necesita para aplicarse. La puse porque, en la práctica, elegir un modelo no depende tanto de qué tan elegante sea la matemática detrás, sino de cómo está armada la red y de cómo se comporta el interferidor.
¿Qué modelos de juego se usan y qué captura cada uno?
| Modelo | Qué captura | Cuándo conviene |
|---|---|---|
| Stackelberg | Comportamiento jerárquico y niveles de decisión | Cuando un jugador fija política y el otro responde |
| Markov | Estados que evolucionan y transiciones | Entornos dinámicos con información incompleta |
| Bimatrix | Relación de confrontación entre dos jugadores | Interacción directa con pagos definidos |
| Hipergrafo | Relaciones de interferencia múltiples y precisas | Redes donde varios nodos se afectan entre sí |
| Equilibrio correlacionado | Señales de interferencia como señales de coordinación | Cuando el ruido del rival puede coordinar decisiones |
En la práctica, no existe un modelo que sirva para todo. El juego de Stackelberg te deja más claro cómo se dan las jerarquías entre las partes; el de Markov se lleva mejor con el aprendizaje por refuerzo profundo; y el hipergrafo evita simplificar interferencias que, en realidad, son colectivas. Cuando tienes varios UAV o sensores desplegados, escoger mal el modelo te puede dar políticas que en simulación se ven bien, pero que fallan en cuanto el interferidor cambia su patrón.
¿Qué es el paradigma de aprendizaje anti-interferencia con teoría de juegos (GTLAJ)?
El paradigma GTLAJ (game-theoretic learning anti-jamming) se propuso como un marco para la comunicación anti-interferencia inteligente. En él se analizan las características del interferidor y los requisitos anti-interferencia, y se discuten modelos como el juego de Stackelberg anti-interferencia, el juego de Markov anti-interferencia y el juego anti-interferencia basado en hipergrafo. Su principal aportación es que unifica el modelado estratégico con el aprendizaje en un solo ciclo: observar, decidir, coordinar, evaluar y aprender.
El marco también deja ver varios retos en el camino: información incompleta, un interferidor que no se queda quieto, el costo computacional y la necesidad de que todo converja cuando el entorno cambia. Justo eso lo plantean Jia et al. (arXiv:2207.00159v1, 20 de junio de 2022), quienes presentan el marco y sus desafíos. A mi parecer, GTLAJ se entiende mejor como una hoja de ruta que como un algoritmo único: ayuda a ordenar qué parte del problema atiende cada modelo y en qué punto conviene meter el aprendizaje.
Combinar teoría de juegos con aprendizaje por refuerzo para interferencia dinámica
La teoría de juegos formula interacciones estratégicas; el aprendizaje por refuerzo maneja información dinámica e incompleta mediante prueba y error. Juntos habilitan el auto-sensado, la auto-decisión, la auto-coordinación, la auto-evaluación y la capacidad de aprendizaje que exige la anti-interferencia inteligente. Gao (2018), citado 130 veces, mostró que las estrategias basadas en un marco de teoría de juegos mejoran el desempeño, verificado con investigaciones numéricas.
En la práctica, el aprendizaje por refuerzo profundo (DRL) y el aprendizaje por refuerzo multiagente (MADRL) aparecen cuando hay varios nodos decidiendo a la vez. Du (2026) propone un enfoque jerárquico de MADRL con teoría de juegos para atacar el acoplamiento fuerte de la asignación multidimensional de recursos. Zhou (2025) aplica aprendizaje por refuerzo auto-organizado a comunicaciones con drones, usando mapas auto-organizados y rebanadas pseudoaleatorias para mejorar la convergencia. El patrón común: el juego da estructura, el aprendizaje da adaptación.
Asignación de recursos en sistemas UAV, aire-tierra e ISAC
En redes integradas aire-tierra, la asignación anti-interferencia es multidimensional: los requisitos de tarea, la movilidad del UAV, la topología de red y las decisiones de acceso al espectro están fuertemente acoplados (Du, 2026, citado 4 veces). No basta con elegir un canal; hay que decidir posición, asociación de usuario, potencia y acceso simultáneamente. El juego jerárquico con MADRL es una respuesta directa a ese acoplamiento.
En ISAC (comunicación y sensado integrados), el objetivo es maximizar la tasa ponderada y la potencia efectiva de sensado bajo un costo de potencia (Chen, citado 15 veces). En EH-CIoT, Li (2024, citado 2 veces) modela el problema como un proceso de decisión de Markov (MDP) sin conocimiento previo y propone un método Linearly Weighted Deep para maximizar el rendimiento de largo plazo (LTT). También existen formulaciones de juego de persecución-evasión para anti-interferencia en AAV, donde un servidor montado en el vehículo y el interferidor interactúan bajo observación parcial; el algoritmo optimiza la política del AAV con RL manteniendo robustez ante no estacionariedad.
Potencia, max-min y water-filling: métodos que sí mueven la aguja
La asignación de potencia es donde más se siente el efecto de la teoría de juegos. La asignación max-min aplicada a anti-interferencia investiga el control de potencia en redes de comunicación con UAV y usa una métrica que refleja el concepto de pago garantizado: protege al usuario en peor condición. Zou (2022), citado 11 veces, reformula el problema de asignación de potencia en comunicación satelital bajo dos casos, con cada jugador con presupuesto fijo repartiendo recursos entre n campos de batalla, y propone equilibrio aproximado y aprendizaje en línea.
Xu (2026) modela juegos entre un interferidor amistoso que difunde ruido artificial y un espía estratégico. Cuando todos los canales están atacados, la asignación óptima de potencia resuelve un problema de optimización convexa mediante water-filling; cuando el espía ataca canales limitados, un juego de suma no cero ayuda a predecir blancos. El resultado reportado es claro: la asignación de potencia con teoría de juegos entrega mejor capacidad total esperada de secrecía que un reparto equitativo ingenuo. Zhao (2025), citado 8 veces, construye un modelo con redes neuronales profundas y teoría de juegos para comunicación anti-interferencia inteligente.
Preasignación proactiva y asignación de energía contra interferencia
Un marco proactivo de preasignación de recursos aborda la asignación anticipada en redes de comunicación desplegadas en campo bajo interferencia dinámica de UAV. La relación entre consumo de recursos y duración de la interferencia está gobernada por un modelo matemático influido por el tipo de tecnología anti-interferencia, la intensidad de la interferencia y la estrategia de asignación (MDPI, 16 de febrero de 2026). La idea es no reaccionar tarde: reservar recursos antes de que el interferidor actúe.
En sensores, la asignación óptima de energía de transmisión multicanal contra interferencia determina estrategias eficientes en energía usando aprendizaje por refuerzo basado en datos para optimizar la potencia de forma adaptativa; se aportan metodología de diseño de parámetros de entrenamiento y pruebas de estabilidad (1 de octubre de 2025). En conjunto, estos trabajos muestran que la ventaja de la teoría de juegos no es teórica: se traduce en menor consumo, mayor rendimiento de largo plazo y mejor secrecía cuando se combina con aprendizaje.
¿Cómo elegir el método correcto para tu escenario?
Mi criterio práctico es empezar por la estructura, no por la moda. Si hay un líder claro y un seguidor, Stackelberg; si el estado cambia y hay información incompleta, Markov más DRL; si varios nodos se interfieren entre sí, hipergrafo; si el problema es reparto de potencia con presupuesto fijo, max-min o water-filling según el objetivo. Si el sistema es aire-tierra con UAV, el acoplamiento multidimensional exige juego jerárquico con MADRL.
También conviene medir el costo de aprender. El aprendizaje en línea y el equilibrio aproximado funcionan cuando la no estacionariedad es manejable; cuando no lo es, la preasignación proactiva reduce el riesgo. En cualquier caso, la combinación de teoría de juegos y aprendizaje supera a los esquemas fijos porque decide con información del entorno en lugar de depender de patrones preestablecidos. Este artículo es análisis técnico y no constituye asesoría de inversión.
Preguntas frecuentes
¿Cómo modela la teoría de juegos la interacción entre un interferidor y un usuario legítimo?
La teoría de juegos trata al interferidor y al usuario legítimo como jugadores con objetivos opuestos, capturando su confrontación natural. Modelos como Stackelberg, Markov, bimatrix e hipergrafo formulan interacciones mutuas y ayudan a derivar estrategias bajo información dinámica e incompleta, donde ninguno conoce por completo las acciones del otro.
¿Qué problemas de asignación de recursos se abordan en la investigación anti-interferencia?
La investigación cubre asociación de usuarios, posicionamiento de UAV, acceso al espectro, selección de canales y control de potencia. En redes integradas aire-tierra, los requisitos de tarea, la movilidad del UAV, la topología de red y las decisiones de acceso al espectro están fuertemente acoplados y se tratan como asignación multidimensional de recursos.
¿Por qué combinar teoría de juegos con aprendizaje por refuerzo para anti-interferencia?
La teoría de juegos formula interacciones estratégicas, mientras que el aprendizaje por refuerzo maneja información dinámica e incompleta mediante prueba y error. Juntos habilitan el auto-sensado, la auto-decisión, la auto-coordinación, la auto-evaluación y la capacidad de aprendizaje que requiere la anti-interferencia inteligente.
¿Qué es el paradigma de aprendizaje anti-interferencia con teoría de juegos (GTLAJ)?
GTLAJ es un paradigma propuesto para la comunicación anti-interferencia inteligente. Explora las características del interferidor y los requisitos anti-interferencia, y discute modelos como el juego de Stackelberg anti-interferencia, el juego de Markov anti-interferencia y el juego anti-interferencia basado en hipergrafo, unificando el modelado estratégico con el aprendizaje.