Anti-Jamming Game Theory Resource Allocation: Modelle, Methoden und Anwendungsfälle
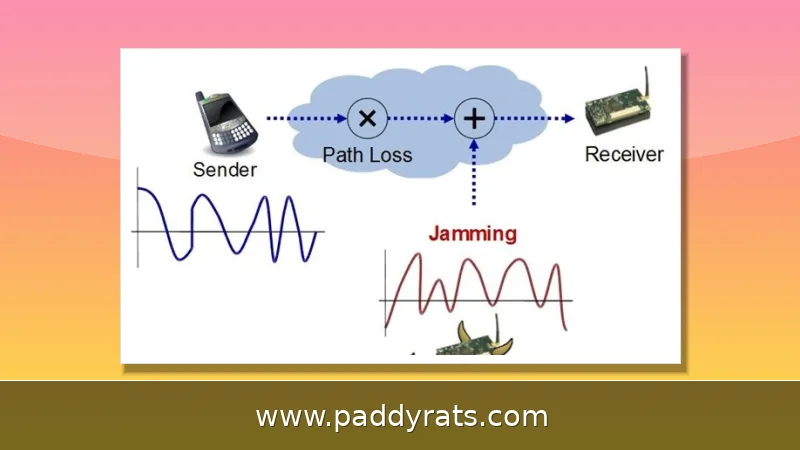
Spieltheorie und Reinforcement Learning verteilen Spektrum, Leistung und Kanäle in drahtlosen Netzwerken so, dass Störer systematisch ausgekontert werden. Der Beitrag erklärt Modelle wie Stackelberg-, Markov- und Hypergraph-Spiele, das GTLAJ-Paradigma und konkrete Anwendungsfälle von UAV bis ISAC.
Was ist Anti-Jamming-Ressourcenallokation und warum ist sie wichtig?
Anti-Jamming-Ressourcenallokation – dahinter verbirgt sich die Frage, wie Spektrum, Sendeleistung, Kanäle, Zeitschlitze und Positionen in drahtlosen Netzwerken so verteilt werden, dass legitime Nutzer auch bei gezielten Störsignalen zuverlässig kommunizieren können. Klassische Verfahren wie FHSS und DSSS arbeiten mit festen oder vorab festgelegten Mustern. Das kostet spektrale Effizienz, denn ein Teil der Ressourcen wird geopfert, um die Übertragungszuverlässigkeit zu sichern – intelligente Entscheidungslogik steckt da nicht dahinter. An genau diesem Punkt setzen spieltheoretische und lernbasierte Ansätze an: Störer und legitime Nutzer werden als Akteure mit gegensätzlichen Zielen modelliert, und daraus lassen sich adaptive Allokationsentscheidungen ableiten.
Anti-Jamming-Ansätze lassen sich in fünf Gruppen unterteilen: Konfrontation, Vermeidung, Eliminierung, Verbergen und Täuschung. Spieltheorie und Reinforcement Learning (RL) gelten dabei als besonders leistungsstarke mathematische Werkzeuge, wie Jia betont (Jia, 2024, zitiert von 94). Gao wiederum zeigt für drahtlose Netzwerke, dass ein spieltheoretischer Rahmen die Leistung messbar verbessern kann – bestätigt durch numerische Untersuchungen (Gao, 2018, zitiert von 130). Der eigentliche Kern liegt aber darin, dass Ressourcen nicht starr zugeteilt werden, sondern sich dynamisch am Störverhalten orientieren.
Wie modelliert die Spieltheorie die Interaktion zwischen Störer und legitimem Nutzer?
Aus spieltheoretischer Sicht sind Störer und legitimer Nutzer zwei Spieler mit entgegengesetzten Zielen – genau diese natürliche Konfrontation lässt sich damit sauber abbilden. Modelle wie Stackelberg-, Markov-, Bimatrix- oder Hypergraph-Spiele beschreiben die wechselseitigen Interaktionen und liefern einen Rahmen, um Strategien trotz dynamischer und unvollständiger Informationen herzuleiten. Dabei setzt der Störer seine Störleistung, die Frequenz oder den Zeitpunkt, während der legitime Nutzer mit Kanalwahl, Leistungssteuerung oder Ausweichmustern reagiert.
Dadurch, dass beide Seiten voneinander lernen, entsteht mit der Zeit ein wiederholtes Spiel – keine einmalige Entscheidung. Das Stackelberg-Spiel zum Beispiel bildet hierarchische Verhaltensweisen ab und schaut sich Wettbewerbsinteraktionen auf verschiedenen Ebenen an: Etwa wenn der Störer zuerst handelt und der Nutzer darauf optimal reagiert. Das Markov-Spiel wiederum erfasst, wie sich Zustände über die Zeit verändern. Das Bimatrix-Spiel beschreibt die Konfrontationsbeziehung recht kompakt, während das Hypergraph-Spiel die genaue Störbeziehung zwischen vielen Knoten abbildet. Und dann wäre da noch das Spiel mit korreliertem Gleichgewicht, das Störsignale selbst als Koordinationssignale nutzt.
Welche zentralen Anti-Jamming-Spielmodelle gibt es?
Die einzelnen Modellfamilien lassen sich vor allem danach unterscheiden, welche Informationsstruktur sie voraussetzen, ob eine Hierarchie zwischen den Akteuren besteht und wie dicht die Interaktionen ausfallen. Die folgende Übersicht ordnet die in der Forschung diskutierten Ansätze ein und zeigt, wofür sie jeweils gedacht sind.
| Modell | Abgebildete Struktur | Typischer Einsatz |
|---|---|---|
| Stackelberg-Spiel | Hierarchische Führer-Folger-Beziehung | Störer handelt zuerst, Nutzer reagiert optimal |
| Markov-Spiel | Zustandsübergänge über die Zeit | Dynamisches Störumfeld mit Lernphasen |
| Bimatrix-Spiel | Konfrontationsbeziehung zweier Spieler | Kompakte Analyse gegensätzlicher Strategien |
| Hypergraph-Spiel | Genaue Störbeziehung vieler Knoten | Dichte Netzwerke mit Mehrfachinterferenz |
| Spiel mit korreliertem Gleichgewicht | Störsignale als Koordinationssignal | Koordination legitimer Nutzer unter Störung |
Solche Modelle liefern nicht nur theoretische Gleichgewichte, sondern auch die Basis für konkrete Regeln zur Ressourcenverteilung. Beim Max-Min-Prinzip wird die Idee garantierter Auszahlungen auf die Leistungssteuerung in einem UAV-Kommunikationsnetzwerk übertragen, das gegen Störangriffe abgesichert werden soll. Im Pursuit-Evasion-Spiel für AAV-Anti-Jamming wiederum wird das strategische Zusammenspiel zwischen einem AAV-Server und einem Störer als ein teilweise beobachtbares Verfolgungsspiel modelliert. Ein RL-Algorithmus optimiert dabei die Anti-Jamming-Strategie des AAV und bleibt auch dann stabil, wenn sich die Bedingungen im Laufe der Zeit verändern, also Nicht-Stationarität herrscht.
Was ist das GTLAJ-Paradigma und welche Anforderungen stellt es?
Das GTLAJ-Paradigma – also das spieltheoretische lernende Anti-Jamming – wurde 2022 in einem Paper von Jia und Kollegen vorgestellt, zusammen mit einem Framework und den offenen Herausforderungen (arXiv:2207.00159v1, 20. Juni 2022). Der Ansatz nimmt Störer-Eigenschaften und die Anforderungen an Anti-Jamming-Maßnahmen systematisch in den Blick und diskutiert verschiedene Modelle: das Stackelberg-Anti-Jamming-Spiel, das Markov-Anti-Jamming-Spiel und das hypergraphbasierte Anti-Jamming-Spiel. Auf diese Weise verbindet GTLAJ die strategische Modellierung der Spieltheorie mit der Anpassungsfähigkeit von Lernverfahren.
Ein intelligenter Anti-Jamming-Ansatz braucht mehr als nur ein paar feste Regeln: Er muss sich selbst wahrnehmen, eigenständig Entscheidungen treffen, sich koordinieren, das eigene Vorgehen bewerten und aus Erfahrung lernen können. Genau hier kommt die Spieltheorie ins Spiel, denn sie beschreibt, wie sich die Beteiligten – also legitime Nutzer und Störer – strategisch zueinander verhalten. Lernverfahren wiederum helfen dabei, mit den dynamischen und unvollständigen Informationen umzugehen, indem sie durch Ausprobieren im Störumfeld dazulernen. Erst wenn beides zusammengedacht wird, lassen sich Ressourcen laufend neu verteilen, anstatt sich auf starre, vorab festgelegte Muster zu verlassen.
Genau diese Anforderungen machen deutlich, warum GTLAJ eher als eigenständiges Paradigma denn als einzelnes Verfahren gilt. Es bietet einen Rahmen, in dem Wahrnehmung, Entscheidungsfindung, Koordination und Bewertung ineinandergreifen – und in dem sich verschiedene Spielmodelle je nach Störszenario miteinander kombinieren lassen.
Warum Spieltheorie mit Reinforcement Learning kombiniert wird
Spieltheorie und Reinforcement Learning ergänzen sich, weil sie unterschiedliche Probleme lösen. Die Spieltheorie formuliert strategische Interaktionen und Gleichgewichte, während RL dynamische und unvollständige Informationen durch Versuch und Irrtum verarbeitet. Zusammen ermöglichen sie die Selbstwahrnehmung, Selbstentscheidung, Selbstkoordination, Selbstevaluierung und Lernfähigkeit, die für intelligentes Anti-Jamming erforderlich sind.
Ein Beispiel ist die Anti-Jamming-Ressourcenallokation in EH-CIoT: Das Problem wird als Markov-Entscheidungsprozess (MDP) ohne Vorwissen modelliert, und eine linear gewichtete Deep-Methode maximiert den Langzeitdurchsatz (Long-Term Throughput, LTT) (Li, 2024, zitiert von 2). Im Drohnenfunk schlägt selbstorganisiertes Anti-Jamming-Reinforcement-Learning RL für die Ressourcenallokation bei dynamischem Jamming vor; selbstorganisierende Karten und pseudozufällige Slots verbessern die Konvergenz (Zhou, 2025, zitiert von 3).
Für stark gekoppelte, mehrdimensionale Allokationsprobleme formuliert ein hierarchischer spieltheoretischer MADRL-Ansatz ein hierarchisches Anti-Jamming-Modell (Du, 2026, zitiert von 4). Die optimale Mehrkanal-Übertragungsenergieallokation gegen Jamming bestimmt energieeffiziente Sensorstrategien mit datengetriebenem RL, adaptiver Leistungsallokation sowie Methodik zur Trainingsparameterauslegung und Stabilitätsnachweisen (1. Oktober 2025).
Welche Ressourcenallokationsprobleme werden in der Anti-Jamming-Forschung adressiert?
Die Forschung deckt Nutzerzuordnung, UAV-Positionierung, Spektrumszugang, Kanalauswahl und Leistungssteuerung ab. In luftgestützten integrierten Netzwerken (Air-Terrestrial Integrated Networks) sind Aufgabenanforderungen, UAV-Mobilität, Netzwerktopologie und Anti-Jamming-Spektrumszugangsentscheidungen stark gekoppelt und werden als mehrdimensionale Ressourcenallokation behandelt (Du, 2026, zitiert von 4). Ein proaktives Rahmenwerk zur Ressourcenvoraballokation adressiert die vorausschauende Zuteilung in im Feld eingesetzten Kommunikationsnetzen unter dynamischem UAV-Jamming (MDPI, 16. Februar 2026).
Das Verhältnis zwischen Ressourcenverbrauch und Jamming-Dauer wird dort durch ein mathematisches Modell beschrieben, das von der Art der Anti-Jamming-Technologie, der Störintensität und der Allokationsstrategie beeinflusst wird. Solche Modelle helfen, Ressourcen nicht erst nach dem Störangriff, sondern antizipativ zu verteilen.
Für integrierte Sensorik und Kommunikation (ISAC) zielt die Anti-Jamming-Ressourcenallokation darauf ab, die gewichtete Summenrate und die effektive Sensorleistung unter Leistungskosten zu maximieren (Chen, zitiert von 15). In der Satellitenkommunikation wird das Leistungsallokationsproblem über Equilibrium-Approximation und Online-Lernen neu formuliert; jeder Spieler hat ein festes Ressourcenbudget und verteilt Ressourcen gleichzeitig auf n Schlachtfelder (Zou, 2022, zitiert von 11).
Sicherheitsperspektive: Abwehrressourcen und Leistungsallokation
Ein verwandtes Feld ist die Optimierung und spieltheoretische Modellierung defensiver Ressourcenallokation in Kommunikations- und Netzwerksicherheit (Xu, 2026). Dort wird das Spiel zwischen einem freundlichen Interferer, der künstliches Rauschen aussendet, und einem strategischen Lauscher modelliert. Sind alle Kanäle angegriffen, löst die optimale Leistungsallokation ein konvexes Optimierungsproblem über Water-Filling; greift der Lauscher nur begrenzte Kanäle an, hilft ein Nicht-Nullsummenspiel bei der Vorhersage der Ziele.
Die spieltheoretische Leistungsallokation liefert dabei stets eine bessere erwartete Gesamtgeheimkapazität als eine naive Gleichverteilung. Das zeigt, dass sich der spieltheoretische Ansatz nicht auf klassisches Jamming beschränkt, sondern auch bei Abhörbedrohungen und kooperativen Gegenmaßnahmen greift.
Ergänzend konstruiert die intelligente Anti-Jamming-Kommunikationstechnik mit tiefen neuronalen Netzen und Spieltheorie ein entsprechendes Modell (Zhao, 2025, zitiert von 8). Damit rücken Lernverfahren und strategische Modellierung auch in sicherheitskritischen Kommunikationsarchitekturen zusammen.
Anwendungsfälle: UAV, luftgestützte Netze und ISAC
Die praktischen Anwendungsfälle reichen von UAV-Kommunikation über luftgestützte integrierte Netzwerke bis zu ISAC-Systemen. Tabelle und Beschreibung zeigen, welche Ressource jeweils im Mittelpunkt steht und welches Verfahren typischerweise zum Einsatz kommt.
| Anwendungsfall | Zentrale Ressource | Verfahren |
|---|---|---|
| UAV-Kommunikationsnetz | Sendeleistung | Max-Min-Leistungssteuerung |
| Luftgestütztes integriertes Netz | Mehrdimensionale Ressourcen | Hierarchisches spieltheoretisches MADRL |
| ISAC | Leistung und Sensorleistung | Gewichtete Summenraten-Maximierung |
| EH-CIoT | Langzeitdurchsatz | Linearly Weighted Deep Method |
| AAV-Anti-Jamming | Anti-Jamming-Politik | Pursuit-Evasion-Spiel mit RL |
Im UAV-Kommunikationsnetz untersucht die Max-Min-Ressourcenallokation die Leistungssteuerung und nutzt eine Max-Min-Metrik, die das Konzept garantierter Auszahlungen widerspiegelt. Im AAV-Szenario optimiert der RL-Algorithmus die Anti-Jamming-Politik des AAV und bleibt robust gegen Nicht-Stationarität.
Für ISAC-Systeme besteht das Ziel darin, die gewichtete Summenrate und die effektive Sensorleistung unter Leistungskosten zu maximieren. In EH-CIoT wird der Langzeitdurchsatz ohne Vorwissen über die Störumgebung maximiert. Diese Beispiele zeigen, dass spieltheoretisches Lernen je nach Anwendungsfall unterschiedliche Ressourcen in den Vordergrund stellt, aber stets auf adaptive Entscheidungen statt fester Muster setzt.
Welche Herausforderungen bleiben offen?
Trotz der Fortschritte bleiben zentrale Herausforderungen bestehen: dynamische und unvollständige Informationen, stark gekoppelte mehrdimensionale Ressourcen, Nicht-Stationarität des Störers und die Konvergenz von Lernverfahren in großen Netzwerken. Das GTLAJ-Paradigma benennt diese Punkte ausdrücklich als offene Forschungsfragen.
Hinzu kommt die Frage, wie sich garantierte Auszahlungen und Effizienz gegeneinander abwägen lassen. Klassische Verfahren mit festen Mustern sind einfach, aber spektral ineffizient; adaptive Verfahren sind leistungsfähiger, erfordern jedoch Modelle, Trainingsdaten und Stabilitätsnachweise. Die Forschung liefert dafür zunehmend Methodik zur Parameterauslegung und Stabilitätsbeweise.
Für die Praxis bedeutet das: Anti-Jamming-Ressourcenallokation ist kein einmalig konfigurierbares Feature, sondern ein fortlaufender Lern- und Koordinationsprozess, der Wahrnehmung, Entscheidung und Bewertung miteinander verbindet. Wer drahtlose Systeme betreibt, sollte diese Architektur bereits bei der Planung berücksichtigen.
Häufig gestellte Fragen
Die folgenden Fragen fassen die wichtigsten Punkte zu Modellen, Ressourcen und der Kombination aus Spieltheorie und Lernen zusammen.
Wie verbessert Spieltheorie die Anti-Jamming-Ressourcenallokation?
Die Spieltheorie verbessert die Anti-Jamming-Ressourcenallokation, indem sie Störer und legitime Nutzer als rationale Spieler mit gegensätzlichen Zielen modelliert. Statt Ressourcen nach festen Mustern zu verteilen, leitet sie Strategien aus Gleichgewichten ab, etwa im Stackelberg-Spiel, in dem der Störer zuerst handelt und der Nutzer optimal reagiert. Numerische Untersuchungen zeigen, dass sich die Leistung auf Basis eines spieltheoretischen Rahmens verbessern lässt (Gao, 2018, zitiert von 130).
Häufig gestellte Fragen
Wie modelliert die Spieltheorie die Interaktion zwischen einem Störer und einem legitimen Nutzer?
Die Spieltheorie behandelt Störer und legitimen Nutzer als Spieler mit gegensätzlichen Zielen und erfasst damit deren natürliche Konfrontation. Modelle wie Stackelberg-, Markov-, Bimatrix- und Hypergraph-Spiele formulieren wechselseitige Interaktionen und helfen, Strategien unter dynamischen und unvollständigen Informationen abzuleiten.
Welche Ressourcenallokationsprobleme werden in der Anti-Jamming-Forschung behandelt?
Die Forschung deckt Nutzerzuordnung, UAV-Positionierung, Spektrumszugang, Kanalauswahl und Leistungssteuerung ab. In luftgestützten integrierten Netzwerken sind Aufgabenanforderungen, UAV-Mobilität, Netzwerktopologie und Anti-Jamming-Spektrumszugangsentscheidungen stark gekoppelt und werden als mehrdimensionale Ressourcenallokation behandelt.
Warum wird Spieltheorie mit Reinforcement Learning für Anti-Jamming kombiniert?
Die Spieltheorie formuliert strategische Interaktionen, während Reinforcement Learning dynamische und unvollständige Informationen durch Versuch und Irrtum verarbeitet. Zusammen ermöglichen sie Selbstwahrnehmung, Selbstentscheidung, Selbstkoordination, Selbstevaluierung und Lernfähigkeit, die für intelligentes Anti-Jamming erforderlich sind.
Was ist das Paradigma des spieltheoretischen lernenden Anti-Jammings (GTLAJ)?
GTLAJ ist ein Paradigma für intelligente Anti-Jamming-Kommunikation. Es untersucht Störer-Eigenschaften und Anti-Jamming-Anforderungen und diskutiert Modelle wie das Stackelberg-Anti-Jamming-Spiel, das Markov-Anti-Jamming-Spiel und das hypergraphbasierte Anti-Jamming-Spiel (Jia et al., arXiv:2207.00159v1, 2022).