Anti-jamming game theory resource allocation: Modeller, metoder og use cases
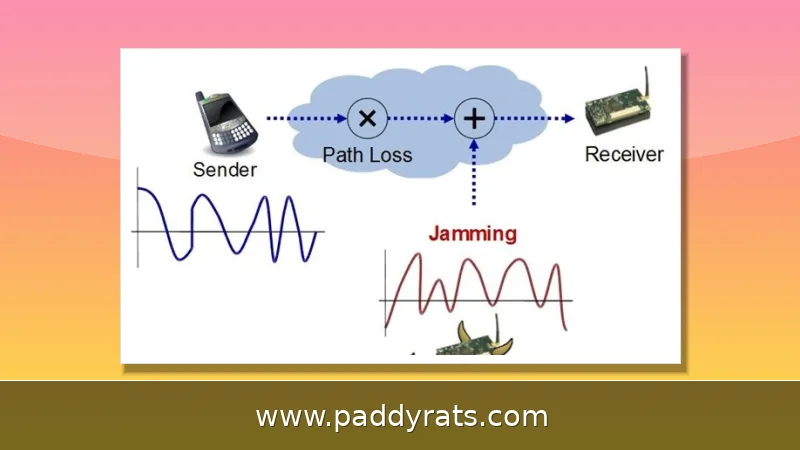
Spilteori og forstærkningslæring er blevet centrale værktøjer til at fordele spektrum, effekt og kanaler i trådløse netværk, hvor en jammer aktivt modarbejder legitime brugere. Her gennemgår jeg modellerne, metoderne og de konkrete use cases inden for anti-jamming resource allocation.
Hvad er anti-jamming resource allocation, og hvorfor er det vigtigt?
Anti-jamming resource allocation drejer sig helt grundlæggende om at fordele de ressourcer, der nu engang er til rådighed – spektrum, sendeeffekt, kanaler og tidsintervaller – så et trådløst netværk bliver ved med at kunne kommunikere, også når en jammer med vilje prøver at forstyrre signalerne. Ressourcerne er knappe, og hver eneste tildeling er derfor et kompromis mellem, hvor pålideligt transmissionen kan foregå, og hvor effektivt båndbredden udnyttes.
Klassiske tilgange som FHSS og DSSS er ikke særlig spektraleffektive – de ofrer kort sagt ressourceudnyttelsen for at sikre, at transmissionen kommer igennem. Problemet er, at de kører efter faste eller forudindstillede mønstre, og der er ingen intelligent beslutningstagning indbygget. Det gør dem nemme at skyde efter for adaptive jammere, som løbende kan tilpasse sig.
Derfor er forskningsfeltet i stigende grad begyndt at trække på spilteori og maskinlæring. Jia (2024) beskriver spilteori og forstærkningslæring som nogle af de stærkeste matematiske værktøjer, man har i anti-jamming-sammenhæng, og hvis man vil gribe det an på en systematisk måde, kræver det evner inden for selvfornemmelse, selvbeslutning, selvkoordinering, selvevaluering og indlæring. Anti-jamming-metoder bliver typisk delt op i fem kategorier: konfrontation, undvigelse, eliminering, skjul og bedrag.
For danske netværks- og sikkerhedsteams betyder det helt konkret, at ressourceallokering ikke længere bare er et spørgsmål om at fordele båndbredde teknisk. Det er i højere grad blevet et strategisk spil mellem legitime brugere på den ene side og en modstander på den anden, som hele tiden tilpasser sig og ændrer taktik undervejs.
Hvordan modellerer spilteori samspillet mellem jammer og legitim bruger?
Spilteori betragter jammeren og den legitime bruger som spillere med modstridende interesser, og på den måde indfanger den den naturlige konfrontation mellem dem. Når man opstiller modeller som Stackelberg-spil, Markov-spil, bimatrix-spil eller hypergraf-spil, kan man beskrive denne gensidige interaktion og samtidig bruge dem til at udlede strategier, selv når informationen er dynamisk og ufuldstændig.
Stackelberg-spillet er især velegnet her, fordi det indfanger hierarkiske adfærdsmønstre og gør det muligt at analysere konkurrenceprægede interaktioner på flere forskellige niveauer. Markov-spillet ser derimod på, hvordan tilstande skifter over tid, mens bimatrix-spillet beskriver selve konfrontationsforholdet mellem de to parter.
Hypergraf-spillet tager det et niveau længere og indfanger det præcise interferensmønster mellem flere samtidige aktører – noget der er helt afgørende i tætpakkede netværk. Det korrelerede ligevægtsspil går endnu videre: her bruges jammingssignalerne ligefrem som koordinationssignaler, så forstyrrelsen ikke bare er et problem, men faktisk bliver en kilde til information.
Gao (2018) brugte numeriske undersøgelser til at vise, at man faktisk kan opnå en mærkbart bedre ydeevne, når man arbejder inden for en spilteoretisk ramme. Og det er værd at hæfte sig ved, at spilteoretiske effektallokeringer konsekvent klarer sig bedre end en naiv, ligelig opdeling, når man ser på den forventede samlede hemmeligholdelses-kapacitet.
Hvilke centrale anti-jamming-spilmodeller findes der?
De modeller, man oftest støder på, dækker hver især en bestemt form for konfrontation og et bestemt informationsniveau. For at give et hurtigt overblik opsummerer tabellen nedenfor de vigtigste af dem, hvad de er gode til, og hvor de typisk bliver taget i brug.
| Model | Fokus | Styrke | Typisk anvendelse |
|---|---|---|---|
| Stackelberg-spil | Hierarkisk adfærd | Analyserer konkurrence på flere niveauer | Effekt- og kanalallokering |
| Markov-spil | Tilstandsovergange | Håndterer dynamisk og ufuldstændig information | Adaptiv spektrumadgang |
| Bimatrix-spil | Konfrontationsforhold | Enkel beskrivelse af to parter | Grundlæggende jammer-bruger-interaktion |
| Hypergraf-spil | Præcist interferensforhold | Fanger flere samtidige aktører | Tætte netværk med mange noder |
| Korreleret ligevægtsspil | Koordination via signaler | Bruger jammingssignaler som koordination | Signaludnyttelse i realtid |
Tabellen viser altså, at valget af model afhænger af, om problemet er statisk eller dynamisk, og om der optræder én eller flere jammere. I praksis bliver modellerne dog ofte kombineret, fordi et netværk sjældent passer perfekt ned i én enkelt spiltype.
Set fra et dansk perspektiv handler det ikke om at vælge model efter en fast opskrift. Man bliver nødt til først at gøre sig klart, om truslen nu er en enkelt strategisk jammer eller snarere et mere komplekst, adaptivt miljø. Først derefter giver det mening at beslutte, om Stackelberg, Markov eller hypergraf skal være grundmodellen.
Hvad er GTLAJ-paradigmet, og hvilke krav stiller det?
Game-theoretic learning anti-jamming (GTLAJ) er et paradigme, der kombinerer spilteoriens strategiske modellering med maskinlæringens evne til at håndtere dynamik og ufuldstændig information. Paradigmet blev formuleret med en samlet ramme og tilhørende udfordringer i Jia et al. (arXiv:2207.00159v1, 20. juni 2022).
GTLAJ undersøger jammerens karakteristika og anti-jamming-kravene og diskuterer modeller som Stackelberg anti-jamming game, Markov anti-jamming game og hypergraf-baseret anti-jamming game. Målet er at skabe en intelligent anti-jamming-kommunikation, der kan tilpasse sig uden at kende jammerens fulde strategi på forhånd.
Et intelligent anti-jamming-system skal kunne sanse sig selv, træffe beslutninger selvstændigt, koordinere med andre noder, evaluere sin egen indsats og lære af erfaringer. Det er netop de fem krav, som GTLAJ-rammen samler under ét.
Uden disse egenskaber ender man med et system, der reagerer for sent. Jammere arbejder ofte i realtid, og hvis ressourcerne skal flyttes i tide, kræver det læring i sløjfen frem for forudindstillede regler.
Hvordan kombinerer man spilteori med forstærkningslæring mod dynamisk jamming?
Spilteori formulerer de strategiske interaktioner, mens forstærkningslæring (RL) håndterer dynamisk og ufuldstændig information gennem trial and error. Tilsammen muliggør de de fem selv-evner, som intelligent anti-jamming kræver.
En central tilgang er at modellere problemet som en Markov Decision Process (MDP) uden forudgående viden. Li (2024) foreslår i EH-CIoT-sammenhæng en Linearly Weighted Deep-metode, der sigter mod at maksimere Long-Term Throughput (LTT). Det viser, at man kan opnå langsigtet effektivitet, selv når miljøet er ukendt.
For dronekommunikation foreslår Zhou (2025) selvorganiserende anti-jamming-forstærkningslæring, hvor RL håndterer ressourceallokering i dynamisk jamming. Selvorganiserende kort og pseudo-tilfældige slices forbedrer konvergensen, hvilket er vigtigt, når beslutninger skal træffes hurtigt.
Du (2026) formulerer en hierarkisk spilteoretisk MADRL-tilgang, der tackler den stærke kobling i multidimensionel ressourceallokering. En anden tilgang er pursuit-evasion-spillet for AAV anti-jamming, hvor samspillet mellem en AAV-monteret server og en jammer formuleres som et delvist observerbart pursuit-evasion-spil, og hvor algoritmen optimerer AAV'ens anti-jamming-politik gennem RL, samtidig med at robustheden mod ikke-stationaritet bevares.
Hvilke ressourceallokeringsproblemer bliver løst i anti-jamming-forskningen?
Forskningen dækker brugerassociation, UAV-positionering, spektrumadgang, kanalvalg og effektkontrol. I luft-terrestriale integrerede netværk er opgavekrav, UAV-mobilitet, netværkstopologi og anti-jamming-beslutninger om spektrumadgang stærkt koblede og håndteres som multidimensionel ressourceallokering (Du, 2026).
For integrated sensing and communication (ISAC) sigter anti-jamming-ressourceallokering mod at maksimere den vægtede sum-rate og den effektive sensing-effekt under en effektomkostning (Chen). Det er et godt eksempel på, at ressourceallokering ikke kun handler om kommunikation, men også om at opretholde sensorkvaliteten.
Max-min-ressourceallokering anvendes i UAV-kommunikationsnetværk til effektkontrol i anti-jamming-systemer og bruger max-min-metrikken, som afspejler begrebet garanteret udbytte. Det betyder, at man beskytter den svageste bruger i stedet for kun at optimere gennemsnittet.
I satellitkommunikation reformulerer Zou (2022) effektallokeringsproblemet i to tilfælde, hvor hver spiller har et fast ressourcebudget og samtidig allokerer ressourcer til n battlefields. Equilibrium approximating og online learning gør det muligt at nærme sig en ligevægt uden at kende hele spillet på forhånd.
Hvordan ser ressourceallokering ud i UAV-, luft-terrestriale og ISAC-systemer?
I UAV-baserede systemer er mobilitet og topologi i konstant forandring, hvilket gør anti-jamming-ressourceallokering særligt vanskelig. En proaktiv ressource-præallokeringsramme for anti-jamming adresserer forudseende ressourceallokering i feltudsendte kommunikationsnetværk under dynamisk UAV-jamming, hvor forholdet mellem ressourceforbrug og jammingsvarighed styres af en matematisk model påvirket af anti-jamming-teknologitype, jammingsintensitet og allokeringsstrategi (MDPI, 16. februar 2026).
For energibegrænsede sensorer er optimal multi-kanal transmission energy allocation mod jamming afgørende. Den bestemmer energieffektive transmission strategier ved hjælp af datadrevet forstærkningslæring, der tilpasser effektallokeringen adaptivt, og der leveres både en metodedesign til træningsparametre og stabilitetsbeviser (1. oktober 2025).
Xu (2026) modellerer spil mellem en venlig interferer, der udsender kunstig støj, og en strategisk eavesdropper. Når alle kanaler er angrebet, løser optimal effektallokering et konvekst optimeringsproblem via water-filling. Når eavesdropperen kun angriber begrænsede kanaler, hjælper et ikke-nulsumsspil med at forudsige målene.
Zhao (2025) konstruerer en model for intelligent anti-jamming-kommunikationsteknologi med dybe neurale netværk og spilteori. På tværs af disse systemer er mønsteret det samme: jo tættere koblingen mellem sansning, kommunikation og ressourceallokering er, desto vigtigere bliver en samlet spilteoretisk og læringsbaseret tilgang.
Hvilke praktiske use cases og erfaringer kan man tage med?
I praksis ser jeg især tre use cases gentage sig. Den første er UAV-kommunikation, hvor droner skal holde forbindelsen under aktiv jamming, og hvor positionering og effektallokering hænger uløseligt sammen. Den anden er ISAC-systemer, hvor både kommunikation og sensing skal beskyttes samtidig. Den tredje er satellitkommunikation, hvor effektbudgettet er fast, og hvor online læring kan forbedre beslutningerne over tid.
En vigtig erfaring er, at spilteoretisk effektallokering konsekvent leverer bedre forventet total hemmeligholdelses-kapacitet end naiv ligelig opdeling. Det lyder måske som en teknisk detalje, men i praksis betyder det, at man ikke bør fordele effekten ligeligt, når trusselsbilledet er asymmetrisk.
En anden erfaring er, at læring kræver tid og data. Derfor bør man tidligt beslutte, om man vil bruge en modelbaseret spilteoretisk tilgang, en datadrevet RL-tilgang eller en hybrid. GTLAJ peger på, at kombinationen af begge verdener ofte er stærkest, fordi spilteorien giver struktur, mens læringen giver tilpasningsevne.
Endelig er der en organisatorisk pointe: anti-jamming-ressourceallokering er ikke kun et algoritmeproblem. Det kræver, at man forstår sin egen trafik, sine prioriteter og sin risikoprofil, før man vælger model. Uden det bliver selv den bedste algoritme bare et værktøj uden retning.
Ofte stillede spørgsmål om anti-jamming og spilteori
Hvordan modellerer spilteori samspillet mellem en jammer og en legitim bruger?
Spilteori behandler jammeren og den legitime bruger som spillere med modsatrettede mål og fanger deres naturlige konfrontation. Modeller som Stackelberg-, Markov-, bimatrix- og hypergraf-spil formulerer den gensidige interaktion og hjælper med at udlede strategier under dynamisk og ufuldstændig information.
Hvilke ressourceallokeringsproblemer bliver løst i anti-jamming-forskningen?
Forskningen dækker brugerassociation, UAV-positionering, spektrumadgang, kanalvalg og effektkontrol. I luft-terrestriale integrerede netværk er opgavekrav, UAV-mobilitet, netværkstopologi og anti-jamming-beslutninger om spektrumadgang stærkt koblede og håndteres som multidimensionel ressourceallokering.
Hvorfor kombinere spilteori med forstærkningslæring mod jamming?
Spilteori formulerer de strategiske interaktioner, mens forstærkningslæring håndterer dynamisk og ufuldstændig information gennem trial and error. Tilsammen muliggør de selvfornemmelse, selvbeslutning, selvkoordinering, selvevaluering og indlæringsevne, som er nødvendige for intelligent anti-jamming.
Hvad er GTLAJ-paradigmet for anti-jamming?
GTLAJ er et paradigme for intelligent anti-jamming-kommunikation. Det undersøger jammerens karakteristika og anti-jamming-kravene og diskuterer modeller som Stackelberg anti-jamming game, Markov anti-jamming game og hypergraf-baseret anti-jamming game. Målet er at gøre systemet i stand til at lære og tilpasse sig i realtid.