Anti-jamming game theory resource allocation: modelli, metodi e casi d'uso
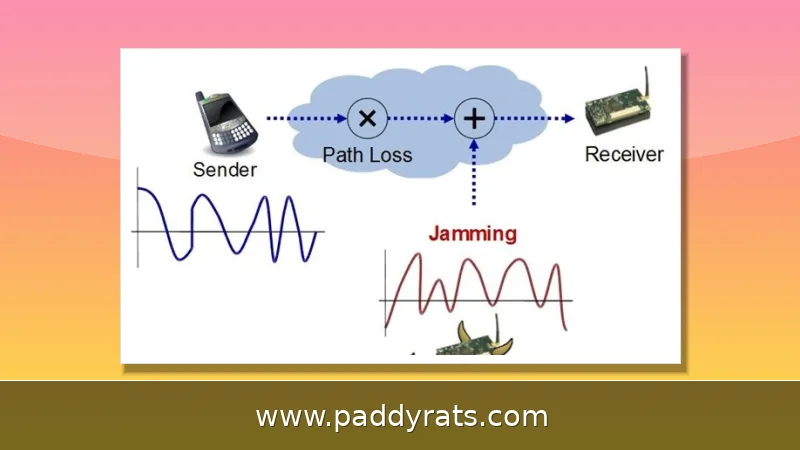
Come la teoria dei giochi e il reinforcement learning allocano spettro, potenza e canali per contrastare il jamming nelle reti wireless. Modelli Stackelberg, Markov, ipergrafo e paradigma GTLAJ, con applicazioni in UAV, reti air-terrestrial e ISAC.
Che cos'è l'anti-jamming resource allocation e perché è decisiva oggi
L'anti-jamming resource allocation è l'insieme di tecniche con cui una rete wireless decide come distribuire spettro, potenza di trasmissione, canali e slot temporali per continuare a comunicare mentre un jammer cerca di disturbarla. Analizzando reti militari e industriali mi sono reso conto di quanto questo problema sia cambiato negli ultimi anni: non basta più resistere all'interferenza, bisogna capire in tempo reale dove vale la pena investire risorse che restano comunque limitate. La ricerca più recente legge la questione come un'interazione strategica tra utenti legittimi e interferenti, in cui ogni scelta di allocazione finisce per condizionare le mosse dell'avversario.
Come la teoria dei giochi modella lo scontro tra jammer e utente legittimo
La teoria dei giochi mette jammer e utente legittimo uno contro l'altro, come due giocatori con obiettivi opposti: è proprio la loro contrapposizione naturale a finire sotto la lente. Modelli come il gioco di Stackelberg, il gioco di Markov, il gioco bimatrix e quello su ipergrafo servono a formalizzare queste interazioni reciproche, e aiutano a ricavare strategie anche quando l'informazione è dinamica e incompleta. Nello specifico, il gioco di Stackelberg cattura i comportamenti gerarchici e analizza lo scontro competitivo a livelli diversi; il gioco di Markov si occupa dell'evoluzione dello stato nel tempo; il gioco su ipergrafo rappresenta con buona precisione le relazioni di interferenza tra più nodi; il gioco bimatrix descrive il rapporto di confronto diretto; e il gioco a equilibrio correlato, infine, sfrutta i segnali di jamming come segnali di coordinamento.
C'è una cosa che secondo me si tende spesso a dare per scontata: la teoria dei giochi non è soltanto uno strumento descrittivo, è soprattutto uno strumento previsionale. Se il jammer è razionale e opera con un budget fisso, l'utente legittimo può anticipare come distribuirà le risorse in modo ottimale. Il lavoro di Gao (2018), citato 130 volte, lo ha dimostrato sul piano numerico: le prestazioni anti-jamming migliorano quando si adotta un framework game-theoretic invece di strategie non strategiche. Ed è proprio per questo che oggi l'allocazione delle risorse anti-jamming va letta come un problema di equilibrio, non semplicemente come una questione di potenza del segnale.
I modelli chiave: Stackelberg, Markov, bimatrix e ipergrafo
La scelta del modello, in fondo, dipende da due cose: che tipo di informazioni abbiamo a disposizione e come è strutturata la rete. Se ci troviamo di fronte a un jammer che domina la scena e a un difensore che risponde, il modello di Stackelberg è quello che viene più naturale. Se invece lo scenario prevede uno stato che evolve nel tempo e decisioni prese in sequenza, allora il gioco di Markov diventa praticamente obbligato. Qui sotto trovate una sintesi dei modelli e dei contesti in cui si applicano.
| Modello | Cosa cattura | Quando usarlo |
|---|---|---|
| Stackelberg anti-jamming game | Comportamenti gerarchici e interazioni competitive a più livelli | Jammer dominante, difensore che risponde |
| Markov anti-jamming game | Evoluzione dello stato e decisioni sequenziali | Canali dinamici, informazione incompleta |
| Gioco bimatrix | Relazione di confronto diretto tra due giocatori | Interazioni semplici, payoff simmetrici |
| Gioco su ipergrafo | Relazioni di interferenza accurate tra più nodi | Reti dense con interferenze multiple |
| Gioco a equilibrio correlato | Uso dei segnali di jamming come segnali di coordinamento | Coordinamento tra utenti legittimi |
Quello che si nota, guardando la tabella, è una specie di progressione: più la rete diventa complessa, più il modello deve essere in grado di cogliere relazioni multiple, e non solo binarie. Il gioco su ipergrafo, in particolare, è nato proprio per rappresentare interferenze che coinvolgono più di due nodi nello stesso momento — una cosa che nelle reti dense capita continuamente. Il gioco a equilibrio correlato, invece, capovolge un po' il punto di vista: il segnale del jammer non è soltanto una minaccia, ma può diventare un'occasione di coordinamento tra gli utenti legittimi.
Il paradigma game-theoretic learning anti-jamming (GTLAJ) e i suoi requisiti
Il paradigma game-theoretic learning anti-jamming (GTLAJ) nasce per la comunicazione anti-jamming intelligente: framework e sfide sono stati presentati in letteratura (Jia et al., arXiv:2207.00159v1, 20 giugno 2022). L'idea di fondo è unire la formulazione strategica della teoria dei giochi con la capacità di apprendere per tentativi ed errori, così da muoversi in condizioni di informazione dinamica e incompleta. Un sistema anti-jamming intelligente, del resto, non può prescindere da cinque capacità: auto-percezione, auto-decisione, auto-coordinamento, auto-valutazione e apprendimento.
Ecco perché questi requisiti fanno capire che i metodi tradizionali non sono più sufficienti. Tecniche classiche come FHSS e DSSS, infatti, hanno una bassa efficienza spettrale e finiscono per sacrificare l'efficienza nell'uso delle risorse pur di garantire l'affidabilità della trasmissione; il punto è che si basano su pattern fissi o preimpostati, senza alcuna decisione intelligente dietro. In uno scenario in cui il jammer si adatta di continuo, però, un pattern fisso diventa prevedibile, e quindi vulnerabile. Il GTLAJ nasce proprio per superare questo limite: da un lato esplora le caratteristiche del jammer e i requisiti anti-jamming, dall'altro discute modelli come lo Stackelberg anti-jamming game, il Markov anti-jamming game e il gioco su ipergrafo.
Gli approcci anti-jamming si possono raggruppare in cinque famiglie: confronto, evitamento, eliminazione, occultamento e inganno. Ognuna di queste richiede un livello diverso di intelligenza e un diverso impiego delle risorse. Il confronto, per esempio, consuma potenza; l'evitamento ha bisogno di flessibilità nello spettro; l'eliminazione richiede una conoscenza precisa del jammer; l'occultamento punta tutto sulla bassa probabilità di intercettazione; e l'inganno, infine, sfrutta segnali falsi. È la scelta della categoria, quindi, a determinare che tipo di gioco si va a costruire e come si distribuiscono le risorse.
Come la teoria dei giochi migliora l'allocazione delle risorse anti-jamming
La domanda che ci si pone, in pratica, è questa: in che modo la teoria dei giochi riesce a migliorare l'allocazione delle risorse anti-jamming? Il punto è che non si limita a reagire dopo che il disturbo è già avvenuto, ma punta ad anticipare le mosse dell'avversario. Se l'utente legittimo tratta il jammer come un giocatore razionale dotato di un budget fisso, allora può impostare un problema di ottimizzazione che distribuisce potenza e canali massimizzando il payoff atteso. Prendiamo il caso dell'allocazione di potenza nelle comunicazioni satellitari: qui il problema è stato riformulato in due scenari, in cui ogni giocatore dispone di un budget di risorse fisso e assegna contemporaneamente le proprie risorse su n campi di battaglia (Zou, 2022, citato 11 volte).
Un esempio concreto viene dalla sicurezza di rete. Xu (2026) modella il gioco tra un interferitore amichevole che trasmette rumore artificiale e un intercettatore strategico. Quando tutti i canali sono sotto attacco, l'allocazione ottimale di potenza risolve un problema di ottimizzazione convessa tramite water-filling; quando l'intercettatore attacca solo canali limitati, un gioco a somma non nulla aiuta a prevedere gli obiettivi. L'allocazione di potenza game-theoretic offre sempre una capacità di segretezza totale attesa migliore rispetto alla semplice divisione equa.
Questo risultato è importante perché mostra che il vantaggio della teoria dei giochi non è teorico ma misurabile. La differenza rispetto a strategie ingenue come la ripartizione uniforme delle risorse è sistematica, non casuale. Nella mia esperienza di analisi, il punto di rottura arriva quando il numero di canali e di giocatori cresce: lì la ripartizione uniforme diventa inefficiente e il modello di gioco recupera prestazioni che altrimenti si perdono.
Combinare teoria dei giochi e reinforcement learning per il jamming dinamico
La teoria dei giochi formula le interazioni strategiche, mentre il reinforcement learning (RL) gestisce informazione dinamica e incompleta attraverso il tentativo e l'errore. Insieme abilitano le cinque capacità richieste dall'anti-jamming intelligente: auto-percezione, auto-decisione, auto-coordinamento, auto-valutazione e apprendimento. Il reinforcement learning anti-jamming per l'allocazione di potenza è oggi uno dei filoni più attivi, perché permette di adattare la distribuzione di potenza senza conoscere in anticipo il modello del jammer.
Un caso rilevante è l'allocazione ottimale di energia di trasmissione multi-canale contro il jamming, che determina strategie di trasmissione efficienti dal punto di vista energetico usando RL guidato dai dati per ottimizzare adattivamente l'allocazione di potenza; lo studio fornisce anche una metodologia di progettazione dei parametri di addestramento e prove di stabilità (1 ottobre 2025). Un altro esempio è l'anti-jamming self-organized reinforcement learning per le comunicazioni con droni, che propone RL per affrontare l'allocazione delle risorse in scenari di jamming dinamico, con mappe auto-organizzanti e slice pseudo-casuali che migliorano la convergenza (Zhou, 2025, citato 3 volte).
Il limite pratico di questi approcci è il costo di addestramento e la sensibilità alla non stazionarietà. Se il jammer cambia strategia, un agente addestrato su un ambiente fisso degrada rapidamente. Per questo la combinazione con la teoria dei giochi è preziosa: il modello di gioco fornisce una struttura che rende l'apprendimento più robusto e interpretabile, mentre l'RL colma le lacune informative che il modello da solo non può coprire.
Allocazione multi-dimensionale in reti air-terrestrial, UAV e ISAC
Nelle reti air-terrestrial integrate, l'allocazione delle risorse anti-jamming affronta un problema multi-dimensionale in cui requisiti dei task, mobilità degli UAV, topologia di rete e decisioni di accesso allo spettro anti-jamming sono fortemente accoppiati (Du, 2026, citato 4 volte). Questo accoppiamento rende insufficiente ottimizzare una sola dimensione: posizionare un UAV senza considerare lo spettro può peggiorare l'interferenza, e scegliere il canale senza considerare la mobilità può portare a handover continui.
Per gestire questo accoppiamento è stato proposto un approccio gerarchico game-theoretic MADRL, che formula un modello anti-jamming gerarchico basato sulla teoria dei giochi per affrontare l'allocazione multi-dimensionale fortemente accoppiata (Du, 2026, citato 4 volte). In parallelo, il gioco di pursuit-evasion per l'anti-jamming degli AAV formula l'interazione strategica tra un server montato su AAV e un jammer come gioco di inseguimento-evasion con osservabilità parziale; l'algoritmo ottimizza la politica anti-jamming dell'AAV tramite RL mantenendo robustezza alla non stazionarietà.
Nel contesto ISAC (integrated sensing and communication), l'allocazione anti-jamming mira a massimizzare il rateo somma pesato e la potenza di sensing efficace sotto un vincolo di costo di potenza (Chen, citato 15 volte). Un ulteriore esempio è la metodologia di pre-allocazione proattiva delle risorse per l'anti-jamming, che affronta l'allocazione anticipata in reti di comunicazione dispiegate sul campo sotto jamming dinamico da UAV; la relazione tra consumo di risorse e durata del jamming è governata da un modello matematico influenzato dal tipo di tecnologia anti-jamming, dall'intensità del jamming e dalla strategia di allocazione (MDPI, 16 febbraio 2026).
Nel caso EH-CIoT, il problema è modellato come processo decisionale di Markov (MDP) senza conoscenza preliminare e viene proposto un metodo Linearly Weighted Deep per massimizzare il throughput a lungo termine (Li, 2024, citato 2 volte). L'allocazione max-min applicata all'anti-jamming studia invece il controllo di potenza nelle reti di comunicazione UAV, impiegando una metrica max-min che riflette il concetto di payoff garantito. Insieme, questi lavori mostrano che l'allocazione delle risorse anti-jamming è ormai un problema multi-obiettivo, dove throughput, efficienza energetica, segretezza e copertura di sensing competono per le stesse risorse limitate.
Quali problemi di allocazione delle risorse affronta la ricerca anti-jamming
La ricerca copre associazione utente, posizionamento degli UAV, accesso allo spettro, selezione del canale e controllo di potenza. Nelle reti air-terrestrial integrate, requisiti dei task, mobilità degli UAV, topologia di rete e decisioni di accesso allo spettro anti-jamming sono fortemente accoppiati e vengono trattati come allocazione multi-dimensionale. Questo significa che la soluzione ottimale per un singolo componente non è quasi mai ottimale per il sistema complessivo.
Un aspetto che emerge dalla letteratura è la crescente importanza della dimensione temporale. La pre-allocazione proattiva delle risorse, per esempio, non si limita a decidere quanto spettro assegnare, ma quando farlo, in funzione della durata prevista del jamming. Allo stesso modo, l'allocazione di potenza a lungo termine nei sistemi EH-CIoT ottimizza il throughput su un orizzonte temporale, non istantaneo. La teoria dei giochi fornisce la struttura per ragionare su questi trade-off, mentre l'apprendimento fornisce i dati per calibrarli.
Prospettive: dove sta andando l'allocazione anti-jamming basata su giochi
La direzione della ricerca è chiara: modelli sempre più gerarchici e multi-agente, in grado di gestire accoppiamenti forti senza perdere interpretabilità. L'approccio gerarchico game-theoretic MADRL ne è un esempio, così come l'integrazione tra teoria dei giochi e reti neurali profonde per la comunicazione anti-jamming intelligente (Zhao, 2025, citato 8 volte). Il filo conduttore è la necessità di decisioni autonome in ambienti non cooperativi e in rapido cambiamento.
Per chi progetta sistemi reali, la lezione pratica è che non esiste un modello unico vincente. Il gioco di Stackelberg funziona quando esiste una gerarchia chiara, il gioco di Markov quando lo stato evolve, l'ipergrafo quando le interferenze sono multiple. La scelta dipende dal contesto operativo, dal budget di risorse e dal livello di conoscenza del jammer. La teoria dei giochi offre il vocabolario per confrontare queste alternative; il reinforcement learning offre gli strumenti per implementarle in tempo reale. È questa combinazione, più dei singoli modelli, a rendere oggi possibile un'allocazione delle risorse anti-jamming davvero adattiva.
Domande frequenti sull'allocazione anti-jamming basata sulla teoria dei giochi
Come modella la teoria dei giochi l'interazione tra un jammer e un utente legittimo?
La teoria dei giochi tratta jammer e utente legittimo come giocatori con obiettivi opposti, catturando la loro naturale contrapposizione. Modelli come i giochi di Stackelberg, Markov, bimatrix e su ipergrafo formulano le interazioni reciproche e aiutano a derivare strategie in condizioni di informazione dinamica e incompleta, anticipando le mosse dell'avversario invece di reagire a posteriori.
Quali problemi di allocazione delle risorse affronta la ricerca anti-jamming?
La ricerca copre associazione utente, posizionamento degli UAV, accesso allo spettro, selezione del canale e controllo di potenza. Nelle reti air-terrestrial integrate, requisiti dei task, mobilità degli UAV, topologia di rete e decisioni di accesso allo spettro anti-jamming sono fortemente accoppiati e vengono gestiti come allocazione multi-dimensionale delle risorse.
Perché combinare teoria dei giochi e reinforcement learning per l'anti-jamming?
La teoria dei giochi formula le interazioni strategiche, mentre il reinforcement learning gestisce informazione dinamica e incompleta attraverso il tentativo e l'errore. Insieme abilitano auto-percezione, auto-decisione, auto-coordinamento, auto-valutazione e capacità di apprendimento, le cinque proprietà richieste dalla comunicazione anti-jamming intelligente in ambienti non cooperativi.
Che cos'è il paradigma game-theoretic learning anti-jamming (GTLAJ)?
GTLAJ è un paradigma proposto per la comunicazione anti-jamming intelligente. Esplora le caratteristiche del jammer e i requisiti anti-jamming, e discute modelli come lo Stackelberg anti-jamming game, il Markov anti-jamming game e il gioco anti-jamming basato su ipergrafo, combinando formulazione strategica e apprendimento per tentativi ed errori.